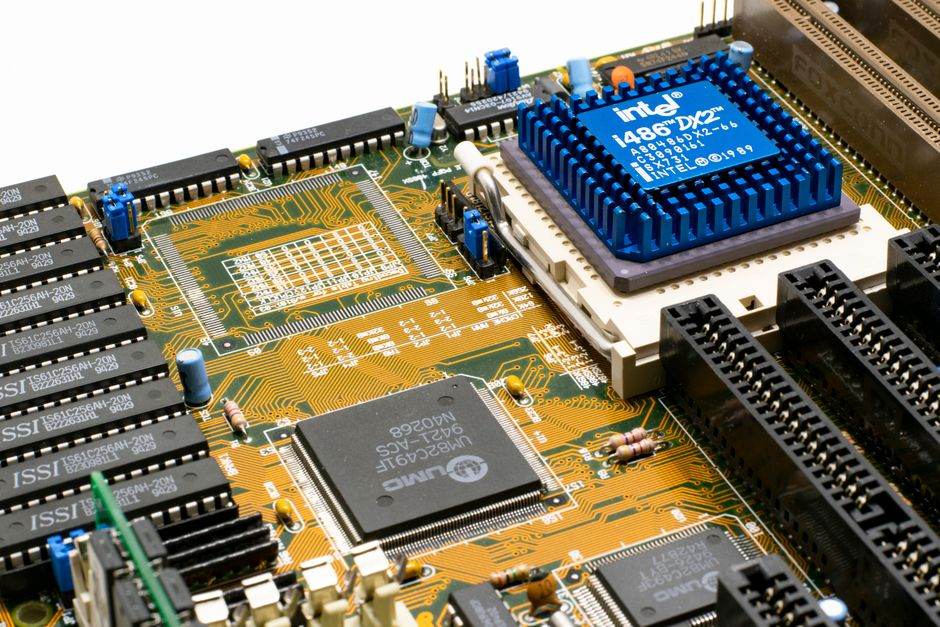
Le 29 septembre 2026Nuvacore a présenté Core First, une méthode qui inverse l’ordre habituel de conception d’un processeur. Au lieu de fixer d’abord le jeu d’instructions, ou ISA, l’entreprise veut concevoir les blocs physiques du composant, dont le CPU, le NPU, le GPU et le contrôleur mémoire. Le jeu d’instructions serait choisi ensuite.
Nuvacore avance que plus de 95 % des blocs de base d’un coeur peuvent être finalisés indépendamment de l’environnement logiciel retenu. La promesse porte donc sur la liberté de conception, pas sur une nouvelle instruction.
Ce déplacement touche d’abord le calendrier. Il ne supprime ni les contraintes logicielles ni les coûts de vérification. Pour juger le gain, il faudra mesurer les performances du système, les échanges de données, la compatibilité logicielle et les contraintes de fabrication.
La puce vient avant l’ISA.
Core First : remettre le silicium devant l’ISA
En apparence, choisir l’ISA à la fin ressemble à une modification du calendrier. En réalité, le jeu d’instructions impose des contraintes sur l’organisation du processeur, l’exécution des opérations et les outils de compilation. Le choix initial peut donc orienter une partie de la puce avant l’optimisation des blocs spécialisés.
Core First sépare ces décisions. Les équipes commencent par les unités de calcul, la mémoire et les interconnexions, puis déterminent l’environnement logiciel adapté au système visé. Un intégrateur pourrait ainsi choisir Arm, x86 ou RISC-V après avoir évalué la structure physique obtenue.
Core First reste une méthode de conception, pas une mesure de produit. L’annonce ne chiffre ni la fréquence, ni la consommation, ni la surface totale, ni le résultat d’une puce commerciale. Pour évaluer le gain, il faudra comparer un composant complet, sa mémoire, ses échanges de données, ses compilateurs et ses applications.
SENECA montre le compromis entre souplesse et rendement
L’architecture des processeurs neuromorphiques ne se résume pas à un choix entre flexibilité totale et circuit figé. L’étude SENECA: building a fully digital neuromorphic processor, design trade-offs and challengespubliée dans Frontiers in Neuroscience en 2023, décrit un compromis entre programmabilité et efficacité.
Un coeur SENECA associe deux contrôleurs. Le premier s’appuie sur RISC-V pour garder un pipeline programmable. Le second, appelé Loop Bufferexécute des micro-instructions optimisées pour les séquences répétitives. Cette hiérarchie laisse les opérations variables au contrôleur flexible et réserve les tâches régulières à un circuit plus simple.
La conception a été synthétisée en technologie GF-22 nm. Un coeur occupe 0,47 mm² et atteint environ 2,8 pJ par opération synaptique lorsqu’une stratégie de réutilisation des données est appliquée. Plusieurs coeurs peuvent être reliés par un réseau sur puce. Le projet vise différents réseaux de neurones, l’apprentissage sur appareil et le pré-traitement comme le post-traitement.
La flexibilité coûte, sauf quand on l’organise.
Quand le processeur saute une opération
L’étude Neuron pruning in temporal domain for energy efficient SNN processor designpubliée dans Frontiers in Neuroscience en 2023, traite un autre goulot d’étranglement des réseaux de neurones impulsionnels : les calculs peu utiles. Le processeur repère les neurones moins importants à partir de leur tension de membrane, puis saute leurs opérations futures.
Les seuils sont définis couche par couche. Deux algorithmes de recherche permettent de régler le compromis entre réduction du calcul et précision selon le niveau de réduction visé.
La méthode a été implémentée en technologie CMOS 65 nm et évaluée sur CIFAR-10. Dans cette configuration, l’étude rapporte une baisse de 57 % de la consommation d’énergie et une accélération de 2,68 fois, avec une perte de précision pouvant atteindre 0,82 % et une surcharge de surface de 7,3 %.
Ces valeurs décrivent cette implémentation et ce jeu de données. Le gain vient ici d’une décision algorithmique autant que d’une décision matérielle : ne pas déclencher une opération lorsque l’état temporel du réseau indique qu’elle apporte peu.
RISC-V garde son ISA, la cryptographie sort du coeur
Un article de Scientific Reports accepté le 11 juin 2026 propose une autre voie : un coprocesseur cryptographique basé sur RISC-V, sans ajout d’instructions au jeu existant. Le schéma prend en charge AES-128 et SHA-256 avec une interface générique destinée à accueillir d’autres blocs de chiffrement.
Les transferts utilisent des entrées-sorties mappées en mémoire, ou MMIO, ainsi qu’un accès direct à la mémoire, ou DMA. Le processeur peut transmettre les données aux unités cryptographiques sans bloquer son pipeline à chaque étape. L’implémentation a été vérifiée sur une carte FPGA Xilinx ZCU-102 avec Vivado 2022.2.
À 64 MHz, le bloc AES-128 atteint 8,2 Gbit/s et le bloc SHA-256 482 Mbit/s selon le comptage des cycles du coeur cryptographique. Cette approche conserve l’ISA RISC-V et déporte le chiffrement dans des unités dédiées, sans modifier le jeu d’instructions.
Ce choix ne règle pas à lui seul le coût d’intégration. Il faut encore maintenir les pilotes, les outils de compilation, les bibliothèques et les blocs spécialisés. Un gain sur le chiffrement peut donc déplacer une partie de l’effort vers la conception et la maintenance.
La logique ternaire descend jusqu’à l’additionneur
Le niveau de spécialisation peut descendre jusqu’à la cellule logique. L’étude Enhanced CPU Design for SDN Controllerpubliée dans Micromachines en août 2024, propose un additionneur complet ternaire à un trit pour le CPU d’un contrôleur de réseau SDN. La conception utilise des transistors CNTFET et a été comparée à 17 architectures dans le simulateur HSPICE.
Les simulations rapportent une réduction du délai de propagation supérieure à 99 % par rapport à un additionneur binaire CMOS de 2 bits, supérieure à 78 % par rapport à une version binaire FinFET de 2 bits et supérieure à 49 % par rapport au meilleur additionneur ternaire comparé.
Ces résultats portent sur un circuit simulé, pas sur le débit d’un contrôleur SDN complet. Il faut encore intégrer la mémoire, les interconnexions, les outils de conception et les contraintes de fabrication. Le cas ternaire montre qu’un choix de représentation numérique peut modifier le circuit élémentaire avant même de traiter les couches supérieures.
Une puce, plusieurs niveaux de spécialisation
Les cinq cas ne mesurent pas la même chose. Core First déplace le choix de l’ISA après la conception des blocs physiques. SENECA répartit le contrôle entre RISC-V et un Loop Buffer. L’élagage temporel saute des opérations de neurones. Le coprocesseur conserve RISC-V tout en déportant AES-128 et SHA-256. L’additionneur ternaire agit au niveau de la logique élémentaire.
Le point commun est concret : chaque fonction reçoit un niveau de matériel adapté à son travail. Le contrôle général, l’accélération neuronale, le chiffrement et l’arithmétique ne suivent pas forcément la même organisation. L’ISA reste nécessaire pour faire fonctionner les logiciels, mais elle ne doit pas dicter chaque bloc de la puce.
L’architecture des processeurs se compare donc avec un protocole commun : même charge de travail, même technologie, même définition de la consommation, mêmes cycles de transfert et même environnement logiciel. Les valeurs de 2,8 pJ par opération synaptique, de 57 % d’énergie économisée et de 8,2 Gbit/s en AES ne répondent pas à la même question.
Au 29 septembre 2026, Core First reste un pari de conception. La méthode sera mesurable lorsqu’une puce complète sera évaluée avec son logiciel, sa consommation, ses échanges de données et ses contraintes de fabrication.
L’ISA arrive plus tard, jamais seule.
Sources et références scientifiques
- SENECA: building a fully digital neuromorphic processor, design trade-offs and challenges – PMC. Frontiers in neuroscience. DOI: 10.3389/fnins.2023.1187252 · PMID: 37425008.
- Abrahamsen J. P., Hafliger P., Lande T. S. (2004). “A time domain winner-take-all network of integrate-and-fire neurons,” in Proceedings of 2004 IEEE International Symposium on Circuits and Systems, Vol. 5 (Vancouver, BC: ). 10.1109/ISCAS.2004.1329537 [DOI] [Google Scholar]. doi:10.1109/ISCAS.2004.1329537.
- Ahmadi-Farsani J., Ricci S., Hashemkhani S., Ielmini D., Linares-Barranco B., Serrano-Gotarredona T. (2022). A cmos-memristor hybrid system for implementing stochastic binary spike timing-dependent plasticity. Philos. Trans. R. Soc. A 380:20210018. 10.1098/rsta.2021.0018 [DOI] [PMC free article] [PubMed] [Google Scholar]. doi:10.1098/rsta.2021.0018.
- Akopyan F., Sawada J., Cassidy A., Alvarez-Icaza R., Arthur J., Merolla P., et al. (2015). Truenorth: Design and tool flow of a 65 mw 1 million neuron programmable neurosynaptic chip. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 34, 1537-1557. 10.1109/TCAD.2015.2474396 [DOI] [Google Scholar]. doi:10.1109/TCAD.2015.2474396.
- Altan A., Aslan Ö., Hacıoğlu R. (2018). “Real-time control based on NARX neural network of hexarotor UAV with load transporting system for path tracking,” in 2018 6th International Conference on Control Engineering & Information Technology (CEIT) (Istanbul), 1-6. 10.1109/CEIT.2018.8751829 [DOI] [Google Scholar]. doi:10.1109/CEIT.2018.8751829.
- Amir A., Taba B., Berg D., Melano T., McKinstry J., Di Nolfo C., et al. (2017). “A low power, fully event-based gesture recognition system,” in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (Honolulu, HI: ), 7243-7252. 10.1109/CVPR.2017.781 [DOI] [Google Scholar]. doi:10.1109/CVPR.2017.781.
- Arthur J. V., Merolla P. A., Akopyan F., Alvarez R., Cassidy A., Chandra S., et al. (2012). “Building block of a programmable neuromorphic substrate: a digital neurosynaptic core,” in the 2012 International Joint Conference on Neural Networks (IJCNN) (Brisbane, QLD: ), 1-8. 10.1109/IJCNN.2012.6252637 [DOI] [Google Scholar]. doi:10.1109/IJCNN.2012.6252637.
- Balaji A., Wu Y., Das A., Catthoor F., Schaafsma S. (2019). “Exploration of segmented bus as scalable global interconnect for neuromorphic computing,” in Proceedings of the 2019 on Great Lakes Symposium on VLSI (Tysons Corner, VA: ), 495-499. 10.1145/3299874.3319491 [DOI] [Google Scholar]. doi:10.1145/3299874.3319491.
- Bamberg L., Joseph J. M., García-Ortiz A., Pionteck T. (2022). “Interconnect architectures for 3d technologies,” in 3D Interconnect Architectures for Heterogeneous Technologies (Springer: ), 27-47. 10.1007/978-3-030-98229-4_2 [DOI] [Google Scholar]. doi:10.1007/978-3-030-98229-4_2.
- Basu A., Deng L., Frenkel C., Zhang X. (2022). “Spiking neural network integrated circuits: a review of trends and future directions,” in 2022 IEEE Custom Integrated Circuits Conference (CICC) (Newport Beach, CA: ), 1-8. 10.1109/CICC53496.2022.9772783 [DOI] [Google Scholar]. doi:10.1109/CICC53496.2022.9772783.
- Bellec G., Salaj D., Subramoney A., Legenstein R., Maass W. (2018). “Long short-term memory and learning-to-learn in networks of spiking neurons,” in Advances in Neural Information Processing Systems, Vol. 31 (Montreal: ). [Google Scholar].
- Bellec G., Scherr F., Subramoney A., Hajek E., Salaj D., Legenstein R., et al. (2020). A solution to the learning dilemma for recurrent networks of spiking neurons. Nat. Commun. 11, 1-15. 10.1038/s41467-020-17236-y [DOI] [PMC free article] [PubMed] [Google Scholar]. doi:10.1038/s41467-020-17236-y.
- Benmeziane H., El Maghraoui K., Ouarnoughi H., Niar S., Wistuba M., Wang N. (2021). “Hardware-aware neural architecture search: survey and taxonomy,” in IJCAI, 4322-4329. 10.24963/ijcai.2021/592 [DOI] [Google Scholar]. doi:10.24963/ijcai.2021/592.
- A scalable security co-processor design for IoT applications – PMC. Scientific reports. DOI: 10.1038/s41598-026-58079-9 · PMID: 42324296.
- 1.Hu, W. et al. An overview of hardware security and trust: Threats, countermeasures, and design tools. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst.40(6), 1010-1038. 10.1109/TCAD.2020.3047976 (2021). [Google Scholar]. doi:10.1109/TCAD.2020.3047976.
- 2.Zheng, B. Internet of things encryption technology combining elliptic curve cryptosystem, hash function, and rfid-based authentication. Discov. Internet Things10.1007/s43926-025-00145-1 (2025). [Google Scholar].
- 3.Kokila, M. & Reddy, K. Authentication, access control and scalability models in internet of things security-a review. Cyber Secur. Appl.3, 100057. 10.1016/j.csa.2024.100057 (2025). [Google Scholar]. doi:10.1016/j.csa.2024.100057.
- raveo-Cacep, M. A. et al. A review on security implementations in soft-processors for IoT applications. Comput. Secur.139, 103677. 10.1016/j.cose.2023.103677 (2024). [Google Scholar]. doi:10.1016/j.cose.2023.103677.
- 5.Sarker, K. A systematic review on lightweight security algorithms for a sustainable IoT infrastructure. Discov. Internet Things5, 47. 10.1007/s43926-025-00150-4 (2025). [Google Scholar]. doi:10.1007/s43926-025-00150-4.
- 6.Asanovic, K., (Editors), D.A.P.: The risc-v instruction set manual, volume i: User-level isa, document version 2.2. Technical report, RISC-V Foundation (2017)..
- 7.Mittal, S., Verma, G., Kaushik, B. K. & Khanday, F. A survey of SRAM-based in-memory computing techniques and applications. J. Syst. Archit.10.1016/j.sysarc.2021.102276 (2021). [Google Scholar]. doi:10.1016/j.sysarc.2021.102276.
- 8.Tsekoura, I., Selimis, G., Hulzink, J., Catthoor, F., Huisken, J., Groot, H., & Goutis, C. Exploration of cryptographic asip designs for wireless sensor nodes. In 2010 17th IEEE International Conference on Electronics, Circuits and Systems, 827-830 (2010). 10.1109/ICECS.2010.5724640.. doi:10.1109/ICECS.2010.5724640.
- 9.Karim Shahbazi, M. E. Design of a specific instructions set processor for AES algorithm. Int. J. Comput. Appl.93(4), 36-40. 10.5120/16205-5496 (2014). [Google Scholar]. doi:10.5120/16205-5496.
- 10.Wang, Z., Jia, Z., Ju, L., & Chen, R. Asip-based design and implementation of RSA for embedded systems. In 2012 IEEE 14th International Conference on High Performance Computing and Communication & 2012 IEEE 9th International Conference on Embedded Software and Systems, 1375-1382 (2012). 10.1109/HPCC.2012.202.. doi:10.1109/HPCC.2012.202.
- 11.Elmohr, M. A., Saleh, M. A., Eissa, A. S., Ahmed, K. E., & Farag, M. M. Hardware implementation of a sha-3 application-specific instruction set processor. In 2016 28th International Conference on Microelectronics (ICM), 109-112 (2016). 10.1109/ICM.2016.7847921.. doi:10.1109/ICM.2016.7847921.
- 12.Safaei Mehrabani, Y. Synthesis of an application specific instruction set processor (ASIP) for RIPEMD-160 hash algorithm. Int. J. Electron. Lett.10.1080/21681724.2018.1477182 (2018). [Google Scholar]. doi:10.1080/21681724.2018.1477182.
- Neuron pruning in temporal domain for energy efficient SNN processor design – PMC. Frontiers in neuroscience. DOI: 10.3389/fnins.2023.1285914 · PMID: 38099202.
- Akhlaghi V., Yazdanbakhsh A., Samadi K., Gupta R. K., Esmaeilzadeh H. (2018). Sna PEA: predictive early activation for reducing computation in deep convolutional neural networks. 2018 ACM/IEEE 45th annual international symposium on computer architecture (ISCA), Los Angeles, CA. 662-673. [Google Scholar].
- Bengio Y., Lamblin P., Popovici D., Larochelle H. (2006). “Greedy layer-wise training of deep networks” in Advances in neural information processing systems (Cambridge, MA: MIT Press; ) [Google Scholar].
- Bu T., Fang W., Ding J., Dai P., Yu Z., Huang T. (2022). Optimal ANN-SNN conversion for high-accuracy and ultra-low-latency spiking neural networks in International conference on learning representations. Available at: (Accessed September 7, 2022).
- Burden R. L., Faires J. D. (1985). Numerical analysis. Boston, MA: Prindle, Weber & Schmidt. [Google Scholar].
- Davies M., Srinivasa N., Lin T., Chinya G., Cao Y., Choday S. H., et al. (2018). Loihi: a neuromorphic Manycore processor with on-Chip learning. IEEE Micro 38, 82-99. doi: 10.1109/MM.2018.112130359 [DOI] [Google Scholar]. doi:10.1109/MM.2018.112130359.
- Deng L., Wang G., Li G., Li S., Liang L., Zhu M., et al. (2020). Tianjic: a unified and scalable Chip bridging spike-based and continuous neural computation. IEEE J. Solid State Circuits 55, 2228-2246. doi: 10.1109/JSSC.2020.2970709 [DOI] [Google Scholar]. doi:10.1109/JSSC.2020.2970709.
- Diehl P. U., Neil D., Binas J., Cook M., Liu S., Pfeiffer M. (2015). Fast-classifying, high-accuracy spiking deep networks through weight and threshold balancing. 2015 international joint conference on neural networks (IJCNN), Killarney, Ireland. 1-8. [Google Scholar].
- Esser S. K., Merolla P. A., Arthur J. V., Cassidy A. S., Appuswamy R., Andreopoulos A., et al. (2016). Convolutional networks for fast, energy-efficient neuromorphic computing. PNAS 113, 11441-11446. doi: 10.1073/pnas.1604850113, PMID: [DOI] [PMC free article] [PubMed] [Google Scholar]. doi:10.1073/pnas.1604850113.
- Gholami A., Kim S., Dong Z., Yao Z., Mahoney M. W., Keutzer K. (2021). A survey of quantization methods for efficient neural network inference. arXiv. doi: 10.48550/arXiv.2103.13630 [DOI] [Google Scholar]. doi:10.48550/arXiv.2103.13630.
- Coles A., Smith A. (2007) Greedy Best-First Search when EHC Fails. Available at: (Accessed November 17, 2019).
- Kim D., Ahn J., Yoo S. (2017). A novel zero weight/activation-aware hardware architecture of convolutional neural network. Design Automat. Test Europe Conf. Exhib. 2017, 1462-1467. doi: 10.23919/DATE.2017.7927222 [DOI] [Google Scholar]. doi:10.23919/DATE.2017.7927222.
- Kim C., Shin D., Kim B., Park J. (2018). Mosaic-CNN: a combined two-step zero prediction approach to trade off accuracy and computation energy in convolutional neural networks. IEEE J. Emerg. Selected Topics Circuits Syst. 8, 770-781. doi: 10.1109/JETCAS.2018.2865006 [DOI] [Google Scholar]. doi:10.1109/JETCAS.2018.2865006.
- Enhanced CPU Design for SDN Controller – PMC. Micromachines. DOI: 10.3390/mi15080997 · PMID: 39203646.
- 1.Rout S., Sahoo K.S., Patra S.S., Sahoo B., Puthal D. Energy Efficiency in Software Defined Networking: A Survey. SN Comput. Sci. 2021;2:308. doi: 10.1007/s42979-021-00659-9. [DOI] [Google Scholar]. doi:10.1007/s42979-021-00659-9.
- 2.Assefa B.G., Özkasap Ö. A Survey of Energy Efficiency in SDN: Software-Based Methods and Optimization Models. J. Netw. Comput. Appl. 2019;137:127-143. doi: 10.1016/j.jnca.2019.04.001. [DOI] [Google Scholar]. doi:10.1016/j.jnca.2019.04.001.
- 3.Saraswat S., Agarwal V., Gupta H.P., Mishra R., Gupta A., Dutta T. Challenges and Solutions in Software Defined Networking: A Survey. J. Netw. Comput. Appl. 2019;141:23-58. doi: 10.1016/j.jnca.2019.04.020. [DOI] [Google Scholar]. doi:10.1016/j.jnca.2019.04.020.
- 4.Jimenez M.B., Fernandez D., Rivadeneira J.E., Bellido L., Cardenas A. A Survey of the Main Security Issues and Solutions for the SDN Architecture. IEEE Access. 2021;9:122016-122038. doi: 10.1109/ACCESS.2021.3109564. [DOI] [Google Scholar]. doi:10.1109/ACCESS.2021.3109564.
- 5.Bhuiyan Z.A., Islam S., Islam M.M., Ullah A.B.M.A., Naz F., Rahman M.S. On the (in)Security of the Control Plane of SDN Architecture: A Survey. IEEE Access. 2023;11:91550-91582. doi: 10.1109/ACCESS.2023.3307467. [DOI] [Google Scholar]. doi:10.1109/ACCESS.2023.3307467.
- 6.Ejaz S., Iqbal Z., Azmat Shah P., Bukhari B.H., Ali A., Aadil F. Traffic Load Balancing Using Software Defined Networking (SDN) Controller as Virtualized Network Function. IEEE Access. 2019;7:46646-46658. doi: 10.1109/ACCESS.2019.2909356. [DOI] [Google Scholar]. doi:10.1109/ACCESS.2019.2909356.
- 7.Das T., Sridharan V., Gurusamy M. A Survey on Controller Placement in SDN. IEEE Commun. Surv. Tutor. 2020;22:472-503. doi: 10.1109/COMST.2019.2935453. [DOI] [Google Scholar]. doi:10.1109/COMST.2019.2935453.
- 8.Xia W., Wen Y., Foh C.H., Niyato D., Xie H. A Survey on Software-Defined Networking. IEEE Commun. Surv. Tutor. 2015;17:27-51. doi: 10.1109/COMST.2014.2330903. [DOI] [Google Scholar]. doi:10.1109/COMST.2014.2330903.
- 9.Sha M., Guo Z., Guo Y., Zeng X. A High-Performance and Flexible Architecture for Accelerating SDN on the MPSoC Platform. Micromachines. 2022;13:1854. doi: 10.3390/mi13111854. [DOI] [PMC free article] [PubMed] [Google Scholar]. doi:10.3390/mi13111854.
- 10.Gomez-Rodriguez J.R., Sandoval-Arechiga R., Ibarra-Delgado S., Rodriguez-Abdala V.I., Vazquez-Avila J.L., Parra-Michel R. A Survey of Software-Defined Networks-on-Chip: Motivations, Challenges and Opportunities. Micromachines. 2021;12:183. doi: 10.3390/mi12020183. [DOI] [PMC free article] [PubMed] [Google Scholar]. doi:10.3390/mi12020183.
- 11.Jaber R.A., Kassem A., El-Hajj A.M., El-Nimri L.A., Haidar A.M. High-Performance and Energy-Efficient CNFET-Based Designs for Ternary Logic Circuits. IEEE Access. 2019;7:93871-93886. doi: 10.1109/ACCESS.2019.2928251. [DOI] [Google Scholar]. doi:10.1109/ACCESS.2019.2928251.
- 12.Zahoor F., Zulkifli T.Z.A., Khanday F.A., Murad S.A.Z. Carbon Nanotube and Resistive Random Access Memory Based Unbalanced Ternary Logic Gates and Basic Arithmetic Circuits. IEEE Access. 2020;8:104701-104717. doi: 10.1109/ACCESS.2020.2997809. [DOI] [Google Scholar]. doi:10.1109/ACCESS.2020.2997809.
- Nuvacore veut révolutionner la conception des processeurs avec sa méthode Core First. 2026.